

适用场景与分析前的准备
网站上线之后,访问日志就像服务器的"监控录像":谁来过、从哪个页面进来的、有没有报错、搜索引擎蜘蛛多久来一次,日志里都记得一清二楚。无论你是个人站长还是企业运维,下面这些场景都用得上日志分析:网站突然变慢想找原因、收录异常想确认蜘蛛抓取情况、服务器带宽跑高想定位异常请求、排查某个页面为什么打不开,以及定期了解网站的真实访问量。
操作前的准备很简单:一台可以登录服务器的终端,以及确认日志文件的位置。Nginx 默认日志在 /var/log/nginx/ 目录下,最常见的是 access.log(访问日志)和 error.log(错误日志);如果使用宝塔面板,站点日志默认在 /www/wwwlogs/ 目录,按域名命名,例如 www.svyun.cn.log。分析前建议先用 ls -lh 看一下日志文件大小,做到心中有数。需要说明的是,日志分析全程都是只读操作,不会影响网站运行;只有后续要做日志清理时才需要谨慎对待。
第一步:看懂 Nginx 访问日志的格式
Nginx 的访问日志默认采用 combined 格式,一行一条记录。随意看几行就能理解字段含义,用 tail -n 20 access.log 即可查看最后 20 行;如果想实时观察访问情况,可以用 tail -f access.log(按 Ctrl+C 退出)。
一条典型的日志长这样,按顺序分别是:访客 IP、身份标识、访问时间、请求方法与 URL、状态码、返回字节数、来源页面(referer)和浏览器标识(User-Agent)。做统计时最常用的就是第 1 段(IP)、第 7 段(URL)和第 9 段(状态码),记住这三个字段的位置,后面的命令就好理解了。
121.32.45.67 - - [05/Nov/2026:10:23:45 +0800] "GET /article/123.html HTTP/1.1" 200 5320 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"另外,日志文件会按天或按大小切割,历史日志通常命名为 access.log.1 或 access.log.20261104.gz。分析压缩格式的历史日志时不要解压到磁盘,直接用 zcat access.log.20261104.gz 管道处理,既省空间又快。
第二步:统计 PV 与独立访客 UV
PV(页面浏览量)最简单:日志总行数就约等于一天的请求总量,执行 wc -l access.log 即可得到数字。注意这里统计的是"请求数",包含静态资源、接口请求和爬虫抓取,和统计工具里纯页面浏览的 PV 口径略有差异,作为量级参考完全够用。
UV(独立访客)在日志里通常按访客 IP 去重统计,用 awk 取第一段 IP 再排序去重:
awk '{print $1}' access.log | sort | uniq | wc -l想看哪些 IP 访问最频繁,把去重改成计数并按数值倒序排列,取前 10 名:
awk '{print $1}' access.log | sort | uniq -c | sort -rn | head -10同理可以统计最热门的页面,取第 7 段 URL 做排行,这能帮你发现哪些内容真正受欢迎:
awk '{print $7}' access.log | sort | uniq -c | sort -rn | head -20如果日志跨越多天,想只看某一天的数据,先用 grep 按日期过滤再统计,例如 grep '05/Nov/2026' access.log | wc -l。日期格式与日志中的时间字段保持一致即可。
第三步:分析状态码分布,定位 404 与 5xx
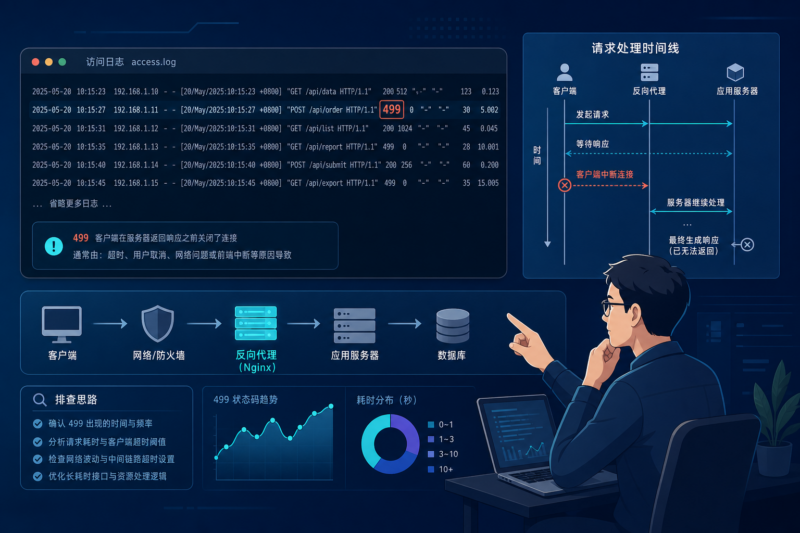
状态码分布是日志分析里最有价值的部分。一条命令看全站状态码构成,正常情况下 200 应该占绝大多数:
awk '{print $9}' access.log | sort | uniq -c | sort -rn如果 404 明显偏多,就要进一步定位是哪些链接失效了。把状态码为 404 的 URL 提取出来做排行,排在前面的往往就是问题页面:
awk '$9==404 {print $7}' access.log | sort | uniq -c | sort -rn | head -205xx 属于服务器错误,更值得警惕,重点看 500、502、503、504 的分布:
awk '$9>=500 && $9<600 {print $9}' access.log | sort | uniq -c | sort -rn找到报错的时间点和 URL 后,再去查对应时段的 error.log 和 PHP、数据库日志,就能定位到具体原因。比如大量 502 通常意味着后端 PHP 或数据库响应超时,需要结合服务器负载一起判断。修改任何配置之前,记得先备份原配置文件,评估对线上业务的影响。
第四步:识别搜索引擎爬虫与异常访问
日志还能告诉你搜索引擎蜘蛛的抓取情况。通过 User-Agent 里的关键词可以分别统计百度、Google、必应等爬虫的抓取量:
grep -E 'Baiduspider|Googlebot|bingbot|Sogou|360Spider' access.log | wc -l也可以反向列出抓取最频繁的爬虫类型,确认新发布的内容有没有被及时收录:
grep -i 'spider\|bot' access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -10除了爬虫,还要留意异常访问:短时间内单个 IP 请求量暴涨、疯狂扫描不存在的路径(表现为大量 404)、频繁 POST 登录接口等,都可能是恶意扫描或攻击的前兆。确认异常 IP 后,可以在防火墙或安全组层面限制,配合 Fail2ban 自动封禁效果更好。需要提醒的是,日志中可能包含访客 IP 等个人信息,对外分享分析结论时注意脱敏,不要直接公开原始日志内容。
常见问题与总结
问题一:日志文件好几 GB,分析时服务器变卡怎么办?避免对超大日志直接 sort,先用 grep 按日期缩小范围,或者用 zcat 只处理需要的切割日志;也可以把日志下载到本地再分析。尽量避开访问高峰期执行统计命令。
问题二:日志统计的 UV 为什么和百度统计、Google Analytics 对不上?两者口径不同:日志按访客 IP 去重,多个用户共用出口 IP 会被算作一个;而 JS 统计工具按 Cookie 或设备标识统计,还能过滤爬虫。数据有差距是正常现象,各自看趋势变化更有意义。
问题三:日志里出现大量 404,要紧吗?要分开看:如果是内链失效、栏目改版导致的死链,应及时修复链接或做 301 跳转;如果是针对固定路径(如/wp-admin、/phpmyadmin)的规律性扫描,则属于恶意探测,封禁 IP 或配置 Fail2ban 即可,不必过度紧张。
问题四:可以让服务器每天自动输出一份日志分析报告吗?可以。把本文的统计命令写进 shell 脚本,用 crontab 设定每天凌晨执行,将结果追加到文件或发送到邮箱,第二天就能直接查看前一天的 PV/UV、状态码和爬虫抓取概况。
总结一下,Nginx 日志分析并不需要复杂工具,几条 awk、sort、uniq、grep 组合命令就足以覆盖日常需求:先看状态码分布掌握整体健康度,再按需统计 PV/UV、热门页面、404 与 5xx 明细,最后识别爬虫和异常访问。建议把本文的命令收藏备用,每周花十分钟跑一遍,很多网站在线率和收录方面的问题,都能在日志里提前发现苗头。






暂无评论内容