
科研 AI 正在从“帮人查资料、写摘要”的工具,变成能够参与研究流程的基础设施。中科闻歌开放磐石·智研决策平台 SciencePro,把 90PB 科学数据、1.7 亿篇论文、3200 万个科研项目和 70 万份产业年报接入一个面向公众的平台,并提供 2000 多个工具与 13 个专家智能体。它所瞄准的已经不是一次问答,而是从项目预审、文献综述到研究方案组织的连续工作。
同一天,Kimi 发布金融行业解决方案,试图把类似能力落到券商、银行、风投和投研机构的具体业务中;科理新序则完成近 5000 万元首轮融资,继续推进能理解 DNA、RNA、蛋白质数据并控制机械臂进行湿实验的 AI Scientist。几条消息放在一起看,科研 AI 的竞争重点正在变化:模型会不会回答只是起点,能不能调用可靠工具、提出可检验假设、执行实验并根据反馈修正,才是下一阶段的分水岭。
科研平台从搜索走向协作
SciencePro 的意义,首先在于它把科研工作里最耗时的资料整理环节重新组织起来。研究者面对的并不只是论文数量多,还包括项目申报书、产业报告、实验方法、数据集和专业软件彼此分散的问题。一个平台如果能够同时理解这些资料,再根据研究目标进行检索、对照和归纳,就有机会把原本需要数天甚至数周的初步调研压缩到更短时间。
不过,工具数量多并不等于研究质量高。科研场景最怕的是引用来源不清、概念混淆和看似完整却无法复核的结论。真正有价值的科研智能体,应当把问题拆解、资料来源、判断依据和未解决部分一起呈现出来,让研究者能够回到原文和数据验证,而不是只得到一份语气肯定的答案。平台越能减少黑箱式总结,越可能进入正式研究流程。
金融应用检验落地能力
Kimi 金融行业解决方案给出了另一个观察角度。官方信息显示,该方案整合 10 多个权威数据源、9 项金融技能和 5 项合规安全措施,可用于资料处理、初稿制作、财务建模和深度研究。相关机构的反馈称,部分工作已经从“天计”压缩到“小时级”,财务建模和深度研究的时间成本也明显下降。
金融机构愿意使用这类系统,前提不是它写得像分析师,而是结果能够进入已有的审核链路。数据是否来自授权渠道,模型有没有把不同口径的指标混在一起,报告中的数字能不能定位到原始出处,都会影响最终决策。金融 AI 因此更像一场工程考试:模型负责理解和生成,数据权限、流程审批、人工复核和操作留痕共同决定它能否真正创造价值。
AI Scientist需要实验闭环
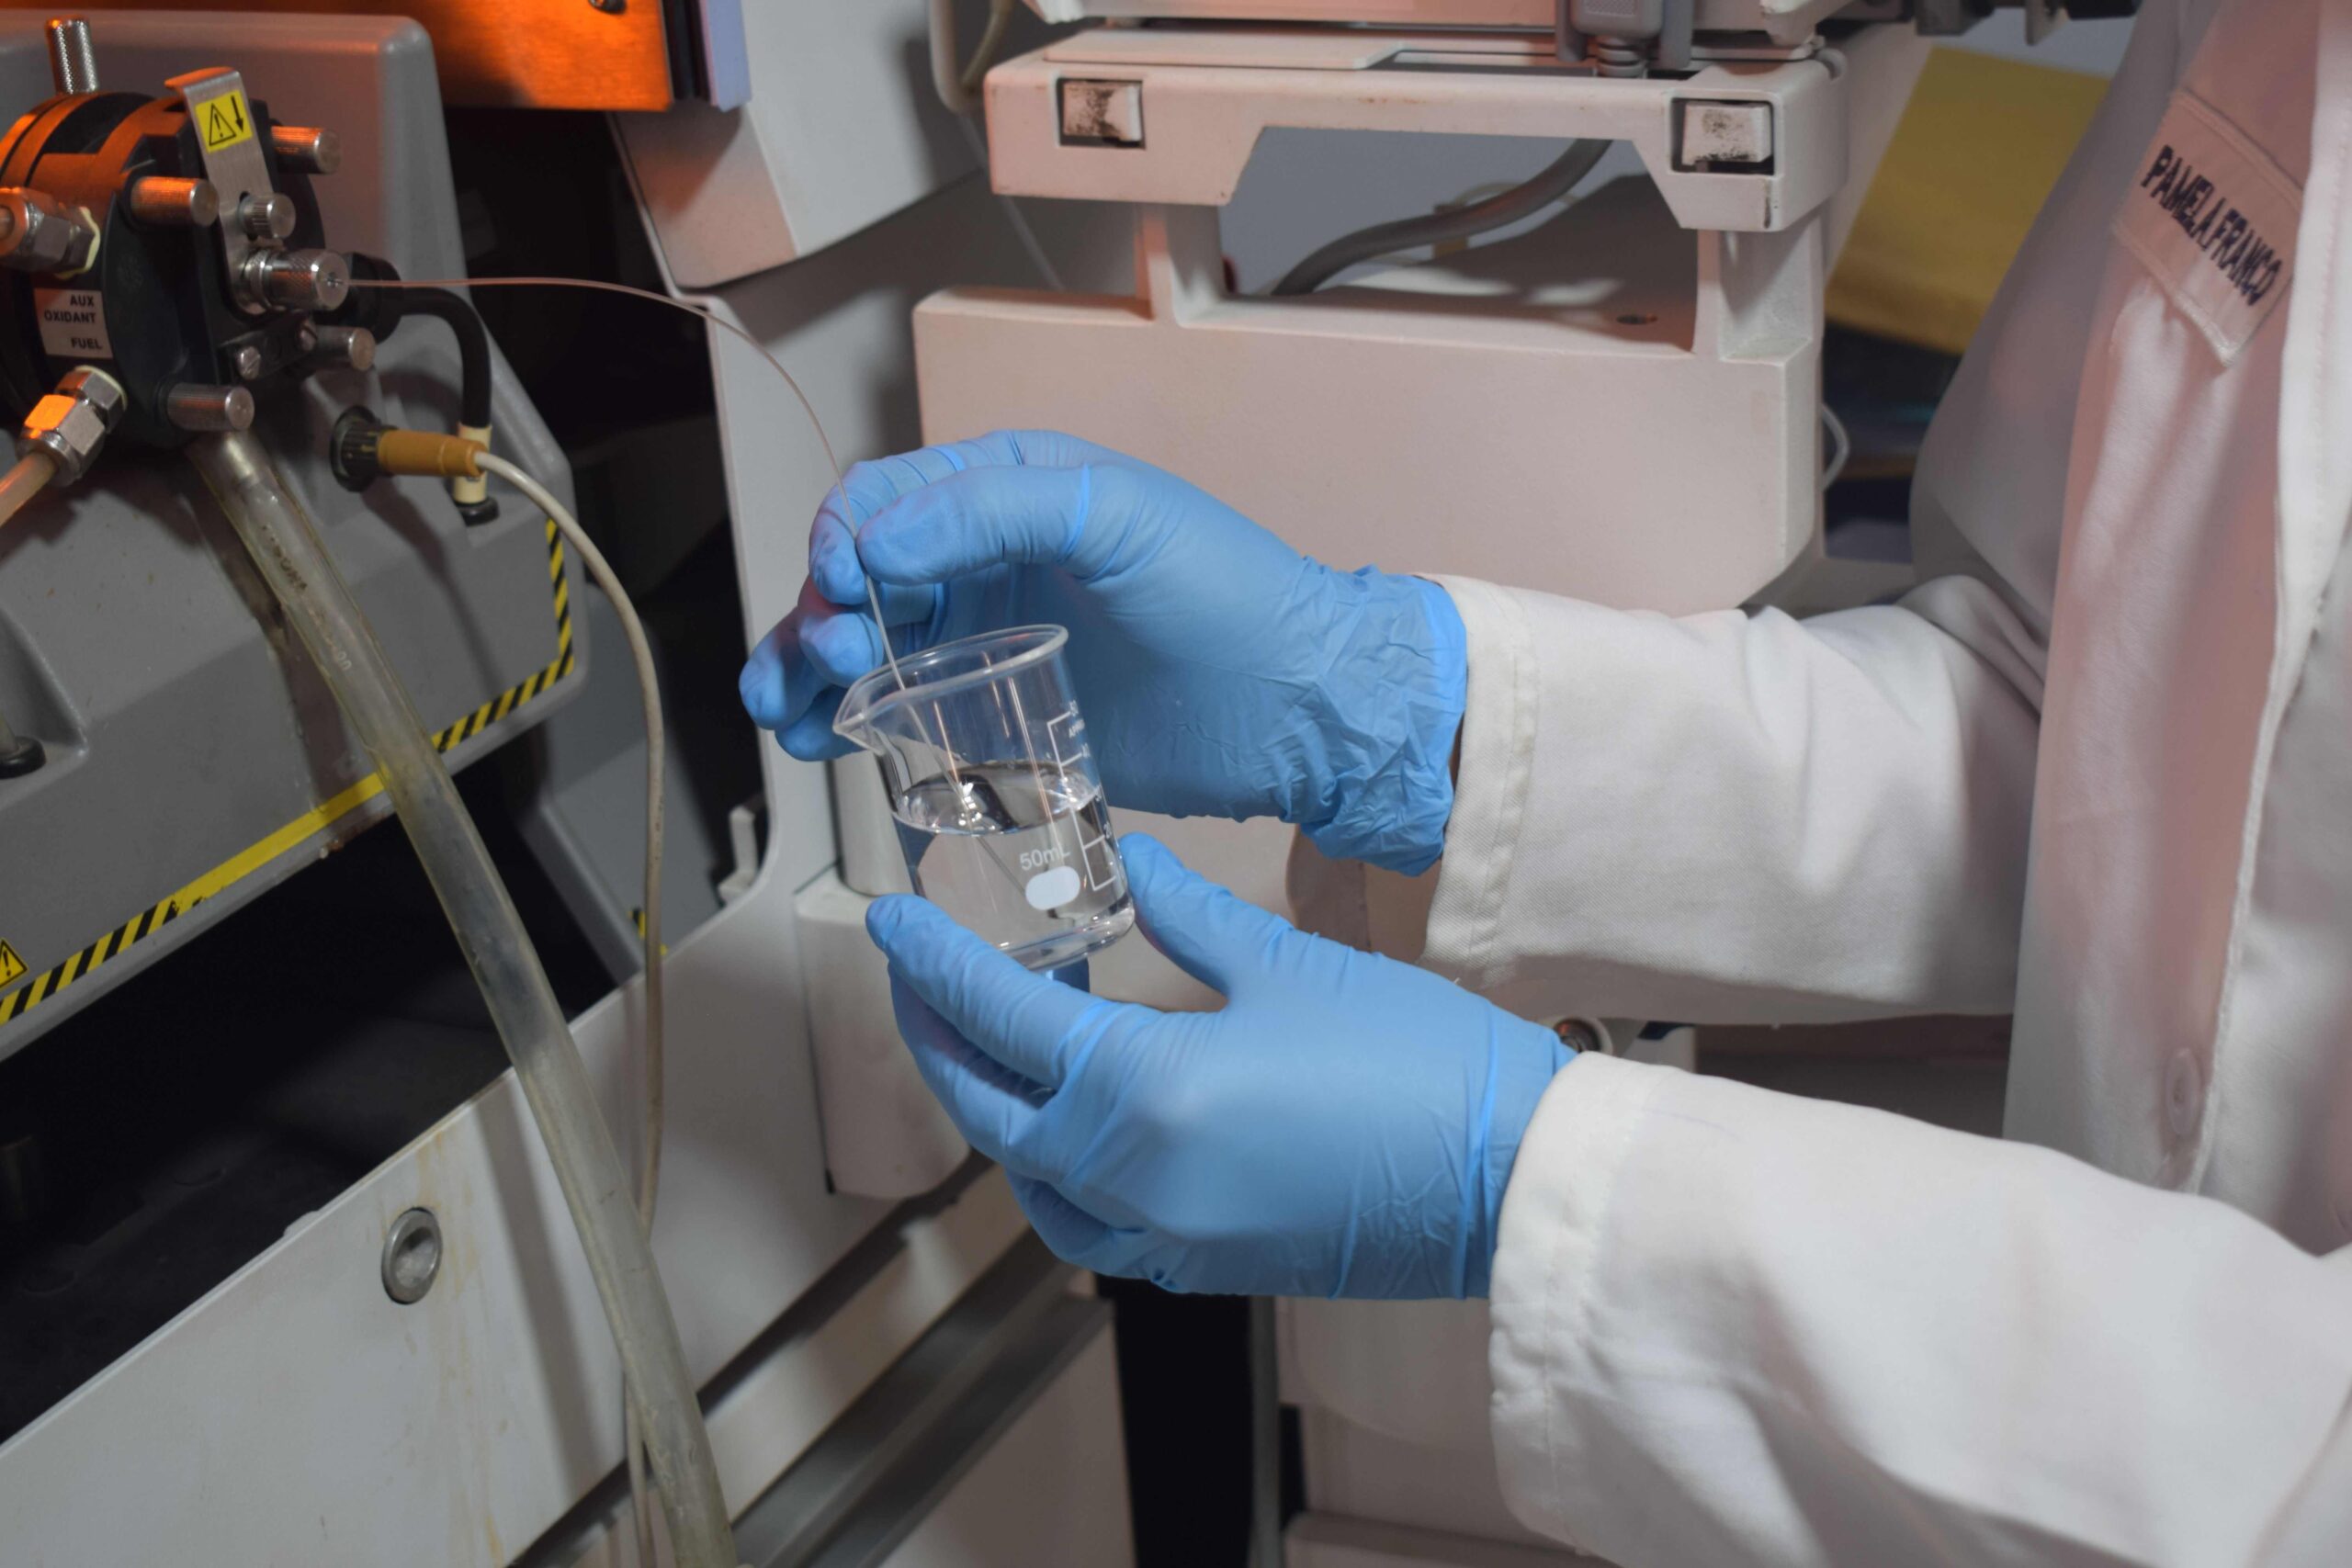
科理新序的融资消息把讨论进一步推向实验现场。团队正在研发能够跨模态理解 DNA、RNA 和蛋白质数据的科学基座模型,同时开发可以控制机械臂完成湿实验的 Agentic-VLA 系列模型,目标是形成“认知—设计—实验—反馈—再学习”的干湿闭环。这里的关键不在于让模型生成一段实验描述,而在于它能否把假设转成可执行步骤。
自动化实验对 AI 的要求远高于普通文本任务。模型需要考虑试剂用量、设备状态、环境约束和安全规则,还要面对实验结果不符合预期的情况。一次失败不能简单地被判定为“答案错误”,系统必须知道是哪一个变量发生变化,哪些结论仍然有效,以及下一轮应该怎样调整。只有把实验日志、传感器数据和结果评价都纳入训练与验证,AI Scientist 才不会停留在概念演示阶段。
真实数据重新成为竞争焦点
今天的另一条消息也说明,科研 AI 的规模竞争不只发生在参数和算力上。Periodic Labs 发布 Neon 模型,在 X 射线衍射分析基准上使用约 1300 张 H200,取得 55.3% 的成功率,报道中称其超过需要 10 万张以上卡的 GPT-6 Astra。无论不同测试之间能否直接比较,这个案例都把注意力拉回到一个事实:专业领域的高质量实验数据,可能比单纯扩大通用训练规模更能改变结果。
材料、药物和生命科学领域的数据往往带有严格的实验条件,数据量未必像互联网文本那样庞大,却包含丰富的物理和化学约束。模型如果能理解谱图、结构和实验过程,就有机会在较小的算力下完成更有效的候选筛选。但这也要求评测必须公开数据来源、任务定义和失败样本,否则“专业模型超过通用模型”的结论很容易被不同口径放大,无法转化为可重复的研究能力。
算力之外还要补齐存储
当科研模型开始处理论文、实验记录和大规模模拟数据,存储系统也会成为瓶颈。焱融 F9000X 在 MLPerf Storage v3.0 测试中公布了 544GiB/s 的聚合带宽,Checkpoint 读写性能位居前列,并提出覆盖训练与推理的 AI 存储方案。对科研机构来说,模型跑得快只是一个指标,数据能否及时供给 GPU、实验版本能否完整保存、结果能否快速回溯,同样决定研究效率。
这也是科研 AI 与普通办公助手的分界线。一次文献总结失败,用户可以重新提问;一次实验数据丢失,可能意味着数周工作无法复原。面向科研的基础设施需要把对象存储、并行文件系统、版本管理、权限审计和备份恢复放在同一套体系里。未来的 AI 研究平台不只是模型加聊天界面,而是计算、存储、数据治理和实验设备共同组成的生产系统。
专业模型开始分工协作
Jev 模型选择只做分类、打分和路由,不承担内容生成,响应速度约为 380 毫秒,输入价格为每百万 Token 0.042 美元。它的方向看似收窄,却很适合放进科研工作流:判断一篇论文是否与课题相关、给实验结果标注优先级、决定调用哪一种分析工具,未必需要一个大型模型长篇推理。
未来的科研 Agent 很可能由多个能力不同的模型共同完成。通用模型负责理解研究目标,检索模型负责找资料,专业模型负责结构预测或谱图分析,轻量判断模型负责分流和质量检查,最后由规则系统和研究人员完成关键确认。这样的分工能够降低成本,也能把错误隔离在局部环节。模型越多,编排和权限管理越重要,平台必须让每一次调用都有边界、有记录、可回滚。
从演示到研究基础设施
科研 AI 进入真实场景后,最值得关注的不是某一个平台的工具数量,也不是某一轮融资的金额,而是它能否持续产出可复核的增量。研究者需要知道 AI 看过哪些资料、提出过哪些假设、执行过哪些实验,以及最终结论经过了怎样的验证。只有证据链完整,AI 才能成为研究伙伴,而不是一台更快的文字加工机。
这条路线也给基础设施提出了更高要求:数据要可追踪,算力要可调度,存储要能承受大规模读写,工具要在权限范围内运行,实验结果要经过人和机器的双重校验。SciencePro、Kimi 金融方案、AI Scientist 和专业模型的进展,正在把同一个问题摆到台面上——AI 是否能够对研究过程负责。答案不会由一次发布会决定,而要在长期、可重复、能经得起复核的真实工作中逐步验证。
暂无评论内容